AMD și Intel unifică inferența AI pe CPU prin PyTorch
ZenDNN se alătură proiectului open-source oneDNN! Intel și AMD au decis să pună capăt fragmentării în procesarea AI pe CPU. Cele două companii colaborează pentru a crea o singură cale de cod…
- autor
- Ana-Maria Tufaru
- publicat
- citire
- 3 min
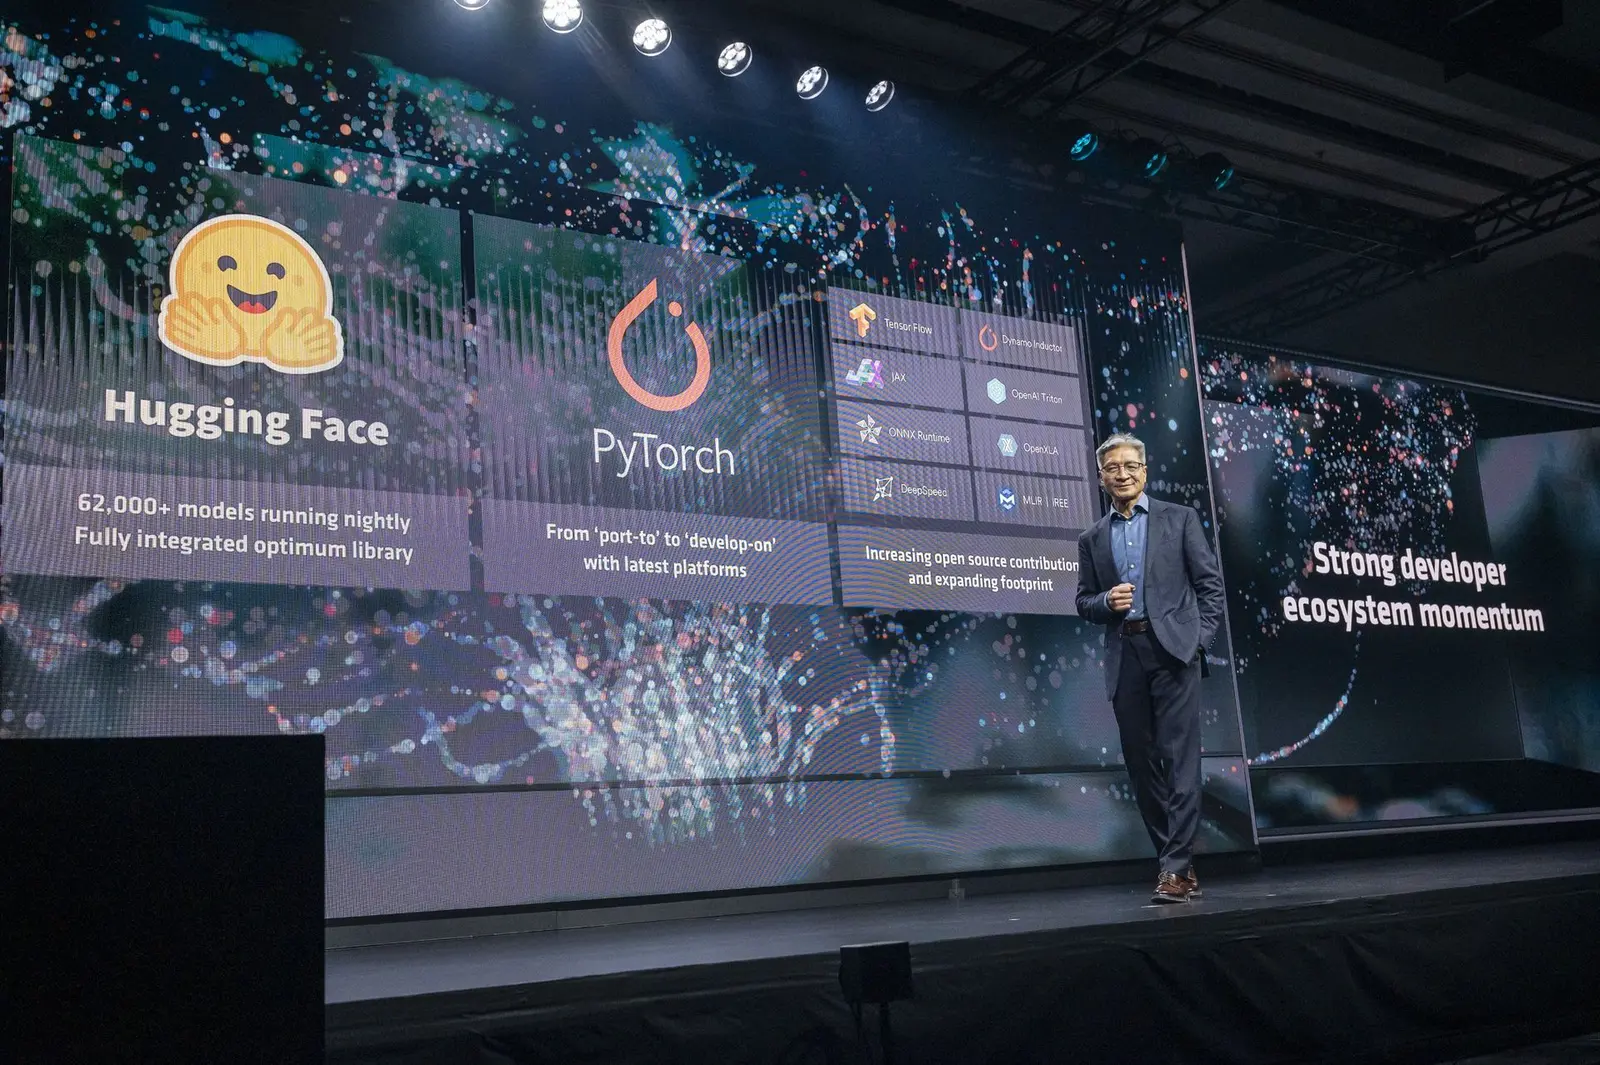
ZenDNN se alătură proiectului open-source oneDNN!
Intel și AMD au decis să pună capăt fragmentării în procesarea AI pe CPU. Cele două companii colaborează pentru a crea o singură cale de cod pentru inferența AI, integrând direct optimizările specifice CPU în cadrul PyTorch.
Scopul este simplu: să simplificăm dezvoltarea pentru task-urile de inteligență artificială care rulează pe hardware standard, nu pe carduri grafice specializate.
Ambii constructori de cipuri își alocă resurse pentru a garanta compatibilitatea arhitecturilor lor respective, vizând cererea tot mai mare pentru procesare locală eficientă, atât în mediul enterprise, cât și pe dispozitivele de consum.
Inima acestei parteneriate este fuziunea bibliotecilor de optimizare într-un sistem unitar. Până acum, inginerii erau obligați să gestioneze lanțuri de instrumente separate pentru fiecare marcă de procesor. Acum, o bibliotecă comună va gestiona ajustările pentru cipurile AMD și Intel. Complexitatea scade semnificativ pentru cei care construiesc aplicații AI. Abordarea unificată se bazează pe biblioteca oneDNN, componenta fundamentală pentru inferența rețelelor neuronale profunde. Prin consolidarea eforturilor, industria speră să coboare bariera de intrare pentru implementarea modelelor AI pe CPU.
suportul unificat pentru dezvoltatori? O schimbare tehnică majoră vine cu integrarea ZenDNN în ecosistemul larg. AMD a menținut de mult timp o versiune downstream a oneDNN, adaptată special pentru procesoarele sale – cunoscută drept ZenDNN.
Compania a ales acum să mută acest cod în proiectul open-source oneDNN. Fundația UXL publică și conduce dezvoltarea oneDNN, cu Intel într-un rol de lider. Tranziția elimină necesitatea ramurilor de mentenanță separate.
Îmbunătățirile de performanță pentru cipurile AMD vor beneficia acum întreaga comunitate. Dezvoltatorii pot accesa nucleele optimizate pentru ambele arhitecturi într-un singur depozit. Alinierea favorizează interoperaționalitatea și ciclu de inovație mai rapid pentru sarcinile AI bazate pe CPU.
Decizia de a unifica aceste biblioteci atacă un punct dureros persistent în stiva software AI. Fragmentarea forța adesea dezvoltatorii să aleagă între optimizări specifice furnizorului sau căi de execuție generice, dar mai lente. Prin fuziunea codului, Intel și AMD oferă o experiență constantă, indiferent de hardware-ul de bază. Acest lucru este crucial pentru scenariile de edge computing, unde eficiența energetică este vitală. CPU-urile rămân o alternativă fiabilă la GPU-uri pentru anumite task-uri de inferență. Biblioteca unificată permite modelelor să ruleze eficient, fără a necesita cantități masive de memorie sau acceleratoare dedicate.
Intel și AMD unifică AI-ul pe CPU prin oneDNN!
Acest lucru susține o gamă mai largă de medii de deploy, de la laptopuri până la centre de date.
Colaborarea semnalează o tendință mai largă spre standarde deschise în infrastructura AI. Deși competiția din piața hardware rămâne acerbă, compatibilitatea software devine o prioritate comună.
Utilizatorii beneficiază de o reducere a overhead-ului de configurare și de metrici de performanță predictibile. Pe măsură ce modelele AI cresc în mărime și complexitate, inferența eficientă pe CPU devine tot mai vitală. Parteneriatul pregăște terenul pentru îmbunătățiri viitoare în tehnici de cuantizare și compresie a modelelor.
Poziționează CPU-ul ca un cetățean de prim rang în ierarhia de calcul AI.
Este această schimbare disponibilă imediat?
Procesul de integrare este în curs, pe măsură ce bazele de cod se fuzionează. Dezvoltatorii ar trebui să se aștepte lansări actualizate ale bibliotecii oneDNN în curând. Aceste update-uri vor include optimizările ZenDNN nou integrate pentru procesoarele AMD.
Înlocuiește această inițiativă accelerarea GPU? Nu, inițiativa țintește specific inferența pe CPU. Completează soluțiile GPU existente, oferind o opțiune robustă pentru mediile fără hardware grafic dedicat. Multe sisteme hibride vor continua să folosească atât CPU, cât și GPU pentru etape diferite ale pipeline-ului AI.
Sursă: Tom's Hardware
Mai multe din Cipuri
Voluntarii Wikipedia declanșează o campanie masivă împotriva textelor generate de AI
Cum recunoaștem nuanțele noului AI? Ellia Lebleu, fondatoare a proiectului WikiProject AI Cleanup, coordonează o inițiativă voluntară lansa…
3 min citire
Giganții coreeni de cipuri actualizează fabricile din China pentru memorie AI
De ce pivotul strategic acum? Samsung Electronics și SK Hynix accelerează modernizarea unităților lor de producție din China. Schimbările v…
3 min citire
ServiceNow și Nvidia lansează Arc: agentul AI care dă liniște corporațiilor
Securitate pe straturi! Lansarea Arc vine cu un scop clar: să disipeze frica companiilor de a adopta agenți autonomi. Mulți decidenți ezită…
3 min citire
Mach9 strânge 34 de milioane de dolari după virajul spre AI CAD
De la hardware la platforme digitale! Mach9 Robotics, startup fondat în 2021, a reușit să adune 34 de milioane de dolari. Suma vine în urma…
3 min citire
Perplexity Computer funcționează acum local pe Mac
procesarea locală Perplexity a anunțat astăzi că instrumentul Perplexity Computer rulează acum complet local pe dispozitivele Mac. Actualiz…
3 min citire
Google aduce inteligența personală în mașini cu Google Built-in
Cum funcționează Personal Intelligence pe Android Auto? Google lansează Personal Intelligence pentru Gemini pe Android Auto și în mașinile …
3 min citire
Discuții
Nicio intervenție încă. Deschide discuția cu prima ta observație.